











從“能回答”到“敢用於業務”:企業知識庫如何建立可信鏈路?
編者按
當AI開始進入企業真正的業務流程,企業關心的問題正在發生變化。過去,我們更關注AI“能不能回答”“回答得準不準”;但當AI開始參與制度審核、質量管理、項目協作、風險研判,甚至進一步調用工具執行任務,僅僅“回答得像是對的”已經遠遠不夠。
業務人員真正需要確認的是:這個答案依據什麼?引用的內容現在還有效嗎?當前用戶和Agent有權使用這些信息嗎?如果答案出了問題,能不能快速找到原因並修正?
上一篇討論了Agent完成真實任務時,需要怎樣的企業上下文,以及RAG、知識編譯、組織記憶和Skill如何共同支撐任務。現在,我們繼續向前一步:當這些知識真正進入審核、判斷和執行流程時,企業該如何建立一條可以核驗、可以追溯、可以糾錯的“可信鏈路”。
本文作者嚴超,360AI知識庫產品負責人。全文約6000字,閱讀約需12分鐘。
一家創新藥研發企業,研發、質量和合規團隊共同維護著大量SOP(標準作業程序)、法規指南、審計資料和質量體系文件。一次制度審核,看起來只是“檢查幾份文件是否一致”,真正做起來卻遠沒有這麼簡單。
審核人員首先要確認:現在執行的到底是哪一版SOP?新增條款是否符合最新法規要求?是否與過去的審計意見沖突?涉及哪些產品和業務範圍?修訂之後,又應該由誰確認、誰審批、什麼時候正式生效?
如果仍然依賴人工翻文件、找版本、逐條比對,問題不僅僅是“效率低”。真正的風險在於:舊版本可能被誤當成現行標準,沖突可能直到審計階段才被發現,修改意見找不到原文依據,修訂完成後也很難確認責任人和處理狀態。
AI可以幫人快速找到資料,但“找到了”,並不代表這些資料都能直接拿來做判斷。例如,當審核人員問“這條要求是否適用於當前產品”,系統可能同時找到一份已經失效的SOP、一份現行法規,以及一條幾年前的審計意見。三份資料都和問題相關,但顯然不能把它們簡單拼在一起,生成一個看似完整的答案。
系統還必須進一步確認:哪一份現在有效、適用於什麼對象、依據來自哪裡、是否存在沖突,以及最終應該由誰確認。
這正是企業知識庫從“能回答”走向“敢用於業務”的分界線。
一條完整的可信鏈路,需要連續完成幾次判斷。系統先確認資料能否用於當前任務,再確認用戶和Agent是否有權調用。資料進入回答以後,每一個關鍵結論還要能夠回到具體依據。任務繼續向下執行時,系統需要檢查操作權限;一旦出現錯誤,也要能沿著記錄找到問題發生在哪一步。後文討論的版本、權限、證據、追溯和知識回流,都屬於這條鏈路。
01 企業真正缺的,不是“看起來正確”的答案
大語言模型很擅長理解和組織文字。只要給它足夠多的材料,它往往可以生成一段邏輯完整、表達流暢的回答。但在企業裡,“說得通”和“可以作為業務依據”,是兩件完全不同的事。
一份制度可能同時存在草稿版、待審版、正式版和失效版;同一個指標,在不同部門、區域和業務範圍內可能采用不同口徑;某個項目中的處理經驗,也未必適用於另一個客戶和階段。甚至有些資料雖然存在於企業內部,但當前員工沒有權限查看,也不應該被Agent用於回答。
需要確認的信息 |
它解決的業務問題 |
來源於原文位置 |
這個結論到底從哪裡來的,能不能回到原文核對 |
版本與狀態 |
使用的是不是當前有效版本 |
適用範圍 |
這條規則適用於哪些產品、區域、客戶或業務 |
責任人與審批 |
誰負責確認、複合和發布 |
權限與密級 |
當前員工和Agent是否有權使用 |
關聯與變更 |
它和哪些法規、項目、審計意見或曆史版本有關 |
因此,模型即使讀懂了文字,也不能自己決定:哪一份資料代表企業當前有效的規則。企業知識庫真正需要管理的,就不能只有“文件裡寫了什麼”,還要知道這份知識的身份和邊界。
02 文件上傳成功,不代表它可以成為業務依據
很多知識庫的問題,其實從資料進入系統的第一步就開始了。一份PDF上傳成功,並不意味著裡面的表格、掃描頁、附件和關鍵條款都已經被準確識別;一份制度已經能被AI搜索到,也不意味著它已經完成審核,可以作為現行規則;同樣,一份曆史項目複盤即使寫得很詳細,也不能默認成為所有項目都可以照搬的處理標準。
所以,企業首先需要區分兩個概念:
“資料進入知識庫”和“資料成為正式知識”,不是一回事。
資料進入系統之後,第一步是把它“讀懂”。系統需要對SOP、法規、審計記錄、質量體系文件,以及來自雲盤和共享目錄中的資料進行解析,把原本散落在文件裡的章節、條款、表格、版本信息等識別出來,並補充必要的標簽和關聯信息。
但做到這一步,只能說明:系統知道這份資料裡有什麼。 接下來還要解決另一個問題:它能不能被業務正式使用?
這就需要進一步檢查資料是否重複、過期、存在沖突,關鍵字段是否缺失,是否包含敏感信息;對於可能直接影響業務判斷的內容,還需要保留原文來源、版本信息和責任人,並經過必要的複核和審批。
因此,一份企業知識從進入系統到真正可用,可以經曆這樣一系列狀態變化:
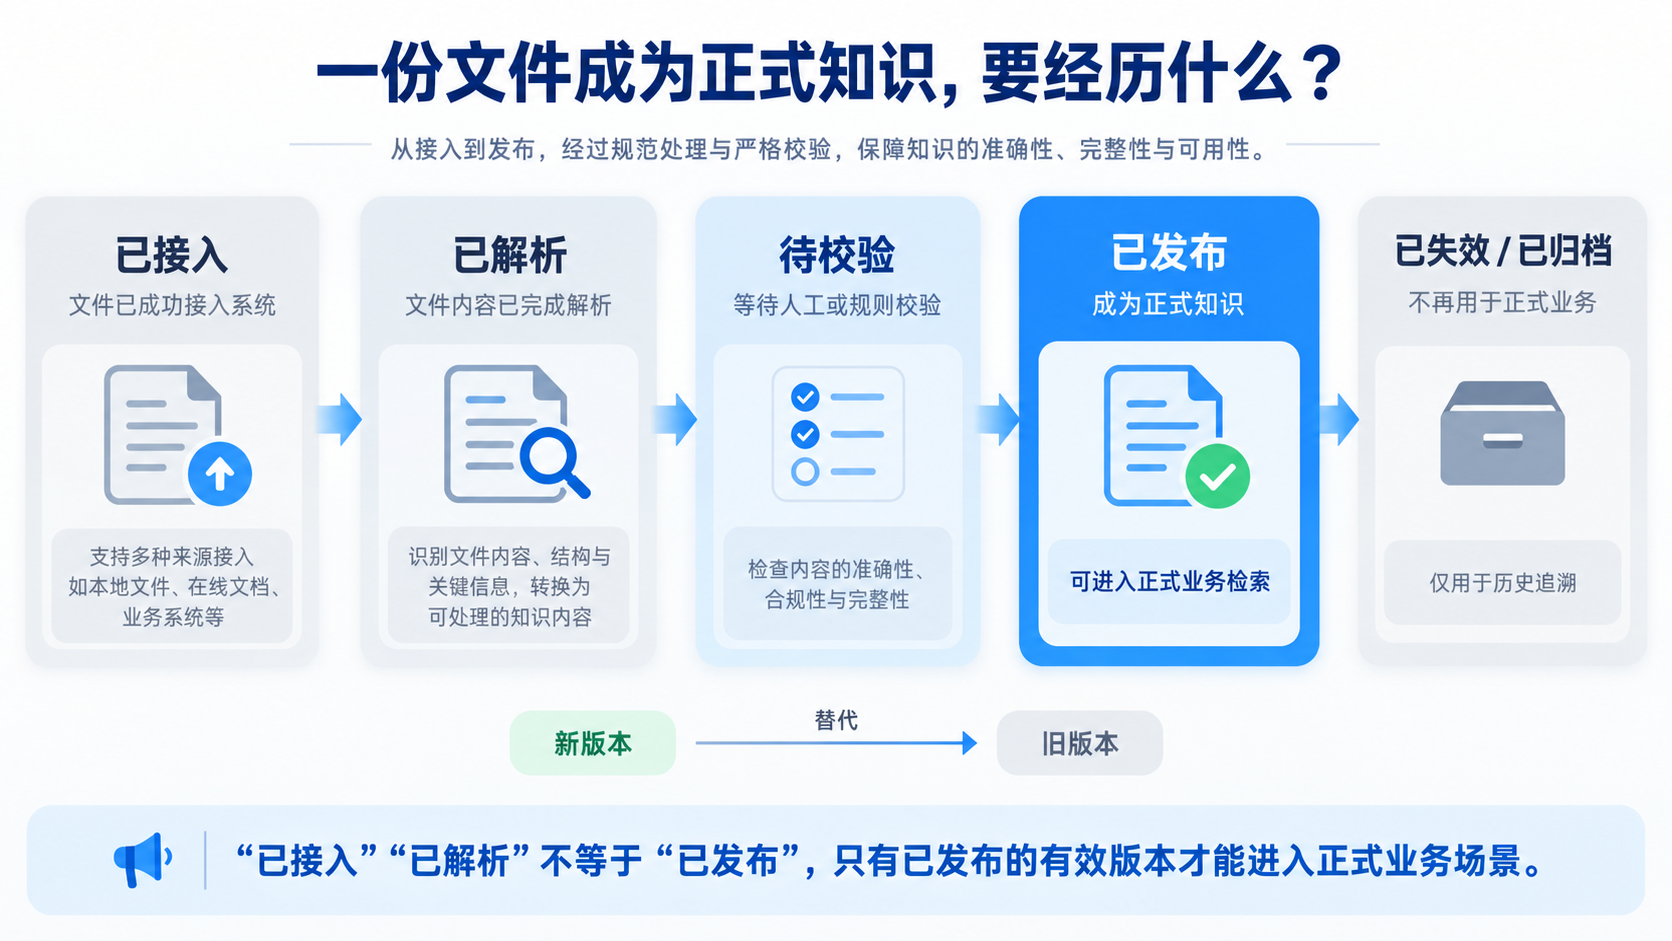
資料處於什麼狀態,決定了它可以怎樣被使用。已發布且已經生效的版本,可以作為當前業務的執行依據;待審版本可以進入審核和差異比對,但不能被系統當成現行規則;已經失效的版本仍可用於審計和曆史追溯。系統需要結合任務目的、生效時間和適用範圍,判斷一份資料在當前任務中承擔什麼作用。
當新版本發布時,系統還需要知道:新版本替代了哪一個舊版本。否則,即使企業已經發布了新制度,AI搜索時仍然可能同時找到新舊兩份文件,最終把本應被淘汰的規則重新帶回業務流程。
所以,“版本管理”並不是給文件名後面加一個V1、V2那麼簡單。它真正管理的是:企業在某一個時間點,到底認可哪一套規則。
回到前面的制度審核場景,系統檢索到三份SOP時,不能簡單選擇日期最新的一份。它還要判斷哪一份已經審批並生效,哪一份仍在待審,當前產品是否屬於它的適用範圍。完成這些判斷以後,資料才能進入後續審核。
03 權限不能只管“文件能不能打開”,還要管“AI能不能使用”
傳統的企業權限管理,大家都很熟悉:員工有沒有權限打開一個文件?但Agent進入企業之後,會出現一個新的問題。
假設某位員工沒有權限查看一份敏感資料。如果知識庫先把這份資料檢索出來,再交給大模型生成答案,即使員工從頭到尾都沒有直接打開原文件,模型仍然可能通過總結、改寫或者跨文件推理,把其中的信息帶進最終回答。
從業務人員的視角看,他“沒有打開文件”;但從AI的工作鏈路看,信息已經被使用了。
因此,企業知識庫的權限控制必須發生在AI生成答案之前。系統需要先根據當前用戶、業務任務、知識空間、資料密級和版本狀態,確定這一次Agent到底可以使用哪些信息;只有經過權限過濾的內容,才能進入後續檢索和回答流程。
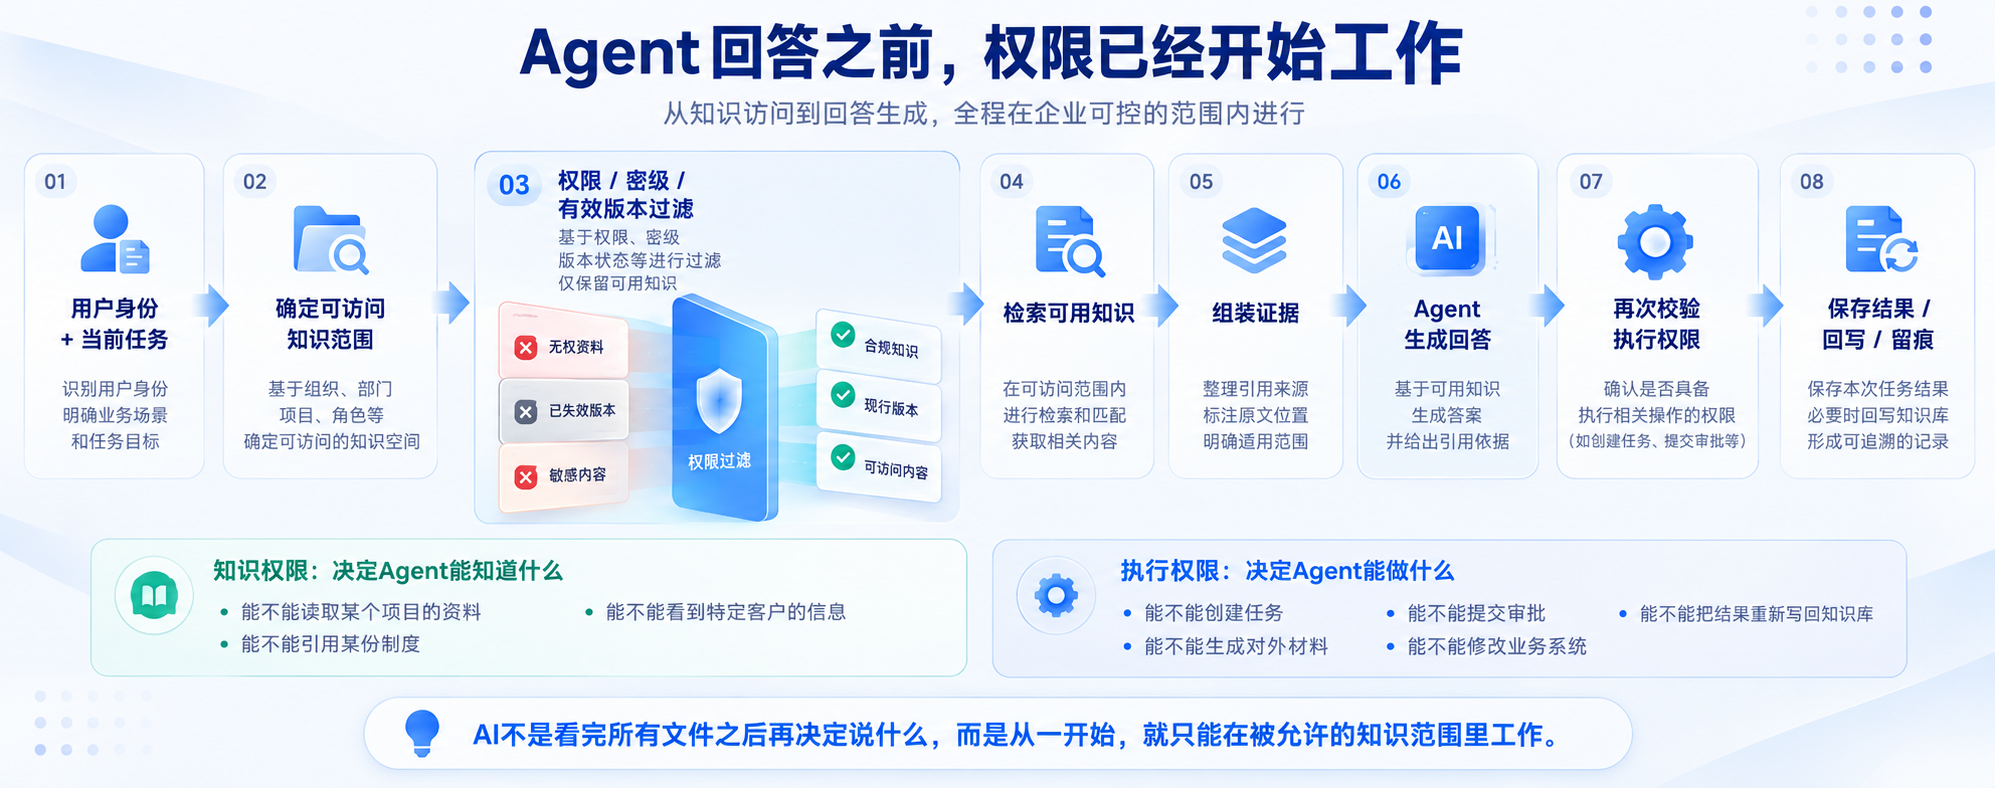
這裡還需要特別區分兩種權限。
第一種是知識權限:決定Agent“能知道什麼”。例如,它能不能讀取某個項目的資料,能不能引用某份制度,能不能看到特定客戶的信息。
第二種是執行權限:決定Agent“能做什麼”。例如,它能不能創建任務、生成對外材料、提交審批、修改業務系統,或者把結果重新寫回知識庫。
兩者不能混為一談。一個Agent可以被允許讀取制度,並根據制度提出“建議修改某條SOP”,但這並不意味著它擁有直接發布新版SOP的權限;同樣,它可以幫助項目組生成一份審核草案,也不意味著可以未經確認直接發送給外部客戶。
“知道”不等於“有權執行”。
當企業開始讓Agent真正參與業務流程時,這個邊界尤其重要。檢索和生成開始前,360AI知識庫會根據當前用戶、業務任務、知識空間、資料密級和版本狀態檢查知識權限,只有符合條件的內容才能進入回答。
當Agent調用Skill、提交審批、修改業務系統或寫回知識庫時,系統還需要檢查它是否擁有對應的執行權限。任務中的檢索、引用和操作也應當留下記錄,便於後續審計和問題追溯。
這些控制發生在不同階段,共同決定Agent可以使用哪些知識,以及任務最多能夠推進到哪裡。Agent能力越強,授權和審批的邊界越要清楚。
04 答案後面有“參考來源”,不代表已經形成證據鏈
現在很多AI問答產品都會在答案下面展示“參考來源”。這是重要的一步,但對於企業業務來說,還不夠。因為業務人員真正想確認的,並不是“AI看過哪幾份文件”,而是:
“剛才這個結論,具體是由哪一處原文支持的?”
進一步,還要知道:這是哪個版本?為什麼適用於當前產品、客戶或者項目?有沒有例外條件?特別是在合規審核、法律檢索、質量管理等場景裡,一條真正有價值的引用,必須能夠幫助業務人員完成複核。
還是以前面的制度審核為例。如果系統最後只給出一句“審核不通過”,這對業務人員的幫助非常有限。一個更可靠的結果,應該讓業務人員清楚看到:當前審核依據的是哪一版制度;發現了哪些沖突或者缺失;這些問題分別對應哪一條制度原文和法規要求;哪些修改建議可以先生成草案;哪些事項必須由質量或合規負責人確認;新版本發布之後,又會替代哪個曆史版本。
最終呈現出來的,不一定是一篇更長的回答,反而可以非常清楚:
結論:發現一處待確認的條款沖突,暫不建議直接發布。
適用範圍:當前產品線、當前審核周期,以現行制度版本為準。
依據:對應SOP條款、現行法規要求及最近一次已確認的審計意見。
版本關系:現行SOP已替代舊版本,舊版本僅用於曆史追溯。
待確認人:質量負責人、合規負責人。
下一步:生成修訂草案,提交複核;確認後再發布新版本。
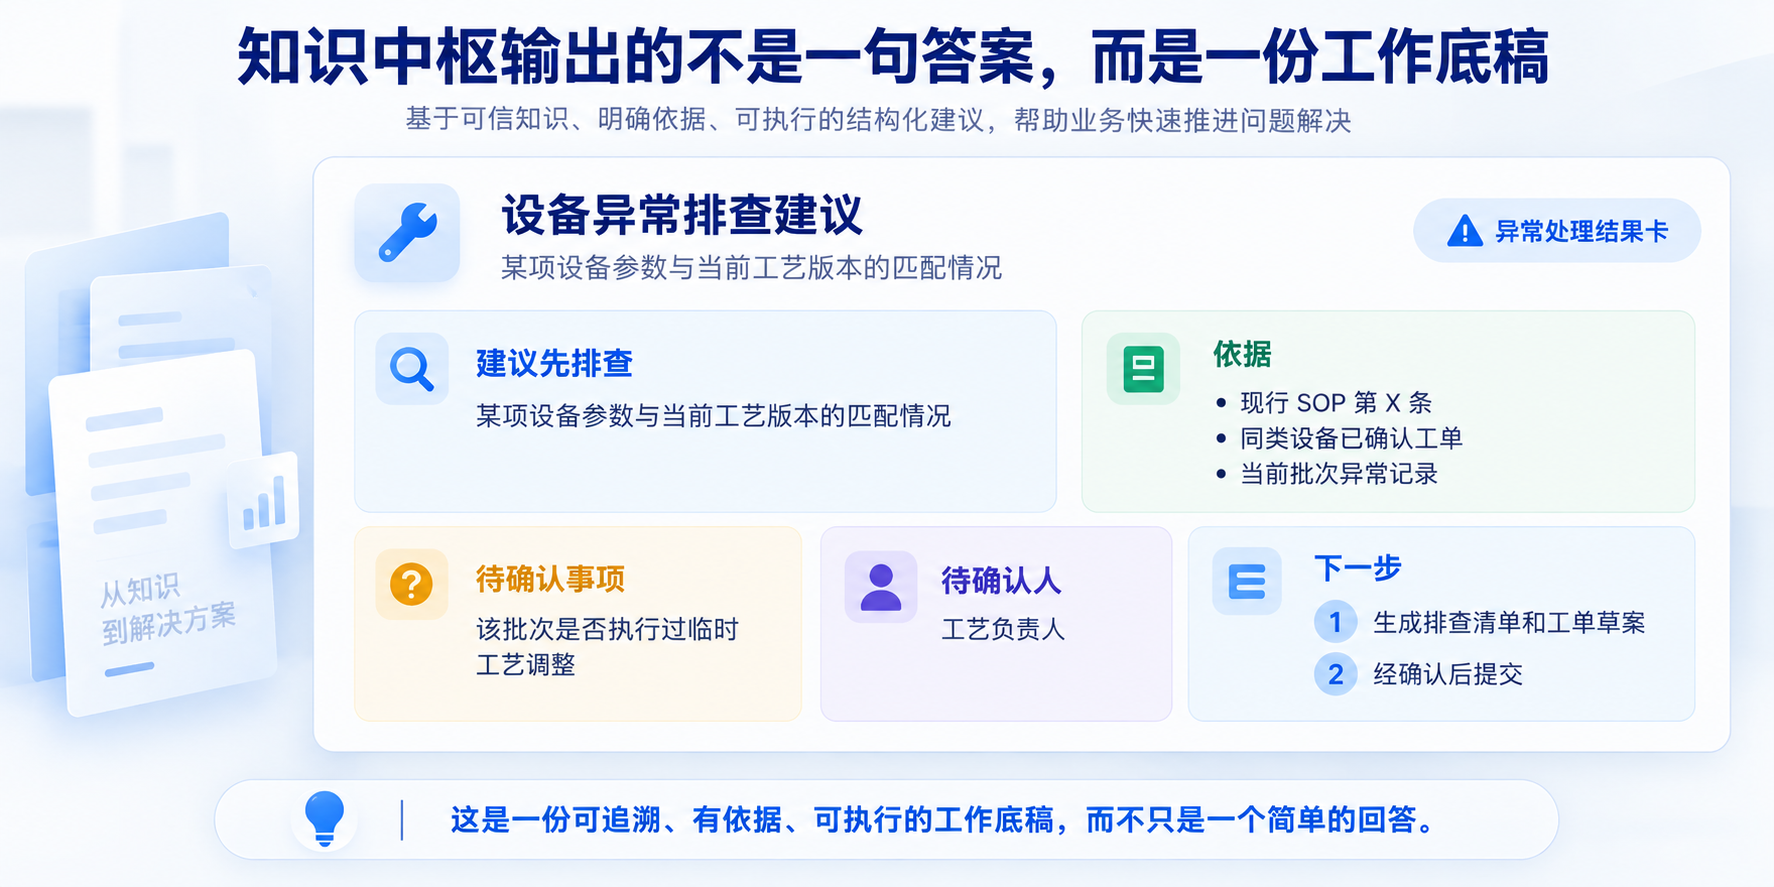
這樣的輸出,價值並不在於“AI寫得更完整”,而在於業務人員可以順著這些信息,快速回到原文、判斷問題,並繼續推進下一步工作。
此時,AI提供的就不再只是一個答案,而是一份可以核對、可以處理、可以繼續流轉的工作底稿。
05 真正的可信,不是保證AI永遠不出錯
企業知識庫不可能永遠不出問題。文件會更新,制度會變化,解析可能遺漏,權限會調整,模型也可能出現判斷偏差。
所以,可信系統真正需要解決的問題,並不是承諾:“AI絕不會出錯。” 而是:“如果出了問題,我們能不能快速知道問題發生在哪裡?”
例如,同樣是“AI回答錯了”,背後可能完全是不同原因:如果回答引用了舊制度,問題可能出在版本狀態沒有同步;如果遺漏關鍵條款,可能是文件解析或內容切分出現問題;如果兩次回答口徑不一致,可能是多個知識源本身就存在沖突;如果回答出現了無權信息,問題可能出在檢索之前沒有正確執行權限過濾。
這些問題並不都應該歸因於“大模型不夠聰明”。很多錯誤,在模型開始生成答案之前就已經發生了。
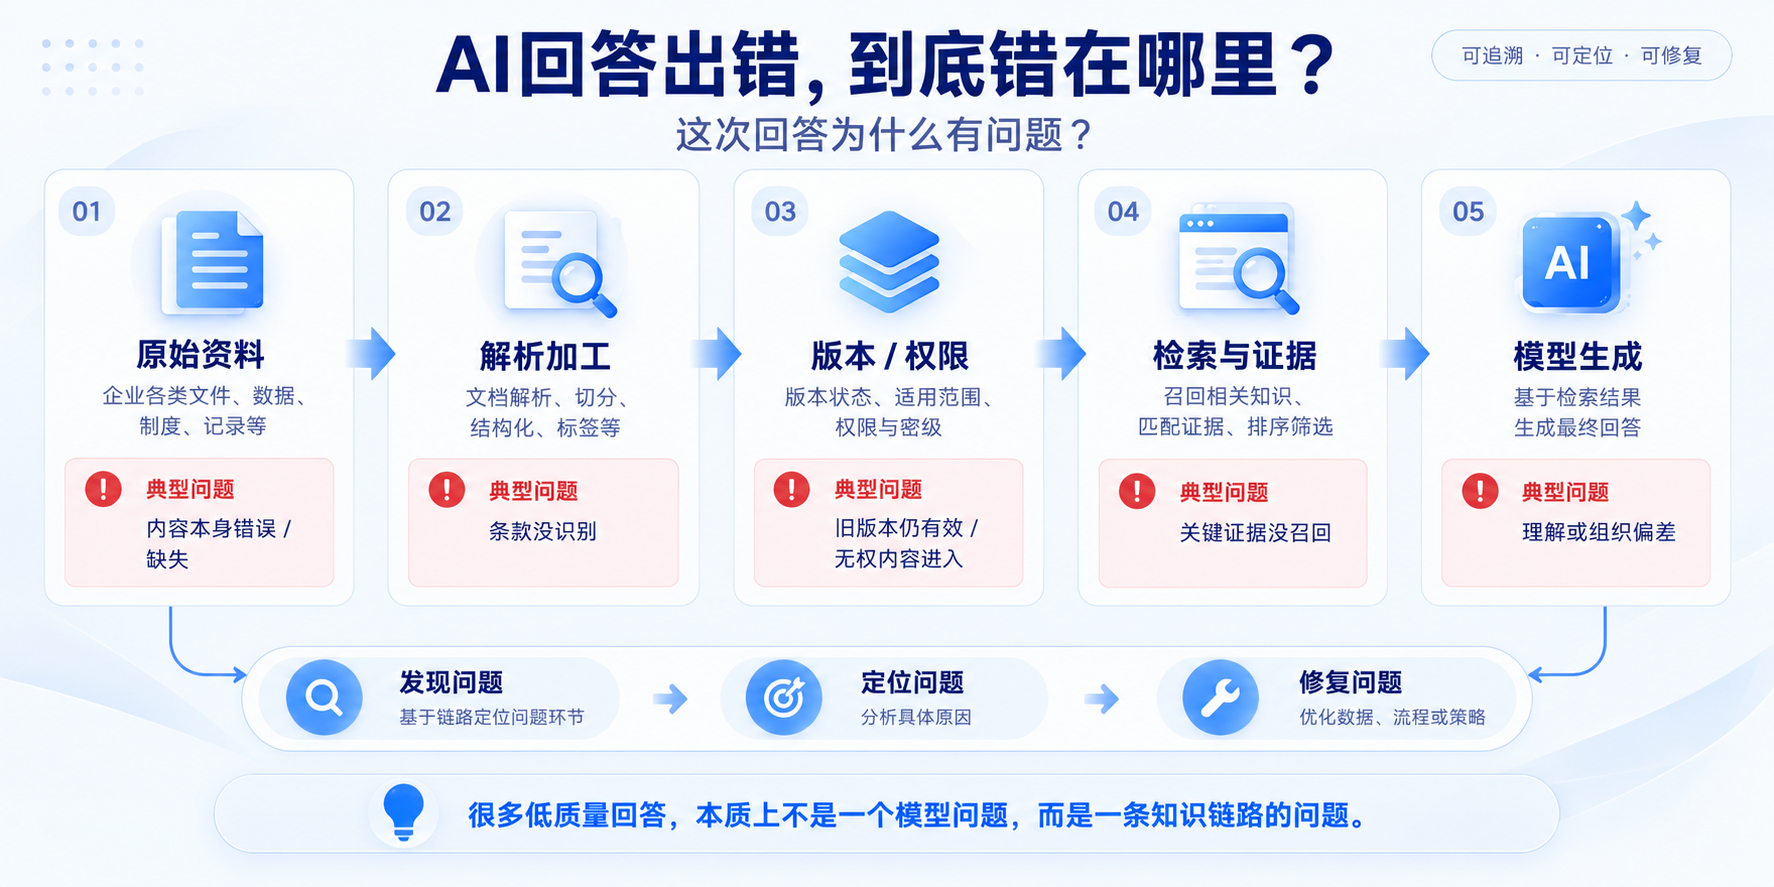
因此,知識庫需要保留完整的運行記錄,包括這次請求發生在什麼時候、誰發起了任務、當時擁有哪些權限、AI檢索過哪些資料、最終采用的是哪個版本、引用了哪些原文、是否調用了其他Skill,又執行了什麼動作。
有了這些記錄,系統才能在問題出現後,從最終答案沿著記錄向前回溯:
到底是資料有問題、版本有問題、檢索有問題、權限有問題,還是最終生成環節出現了偏差。
這也是自動化評測真正有價值的地方。企業對AI的評測不能只看“答案像不像標準答案”,還需要繼續判斷引用是否有效、版本是否正確、權限有沒有越界、沖突有沒有被識別、任務最終有沒有形成閉環。
評測的目標不是單純給模型一個分數,而是幫助企業做到:
發現問題→ 找到原因 → 修複問題 → 重新驗證。
當AI真正進入生產環境,這種“可定位、可修複”的能力,往往比追求某一次回答的滿分更重要。
06 “越用越聰明”,不是把所有AI對話都存進知識庫
很多企業都希望知識庫能夠“越用越聰明”,但這句話很容易產生另一個誤區:把員工和AI的所有對話、所有回答、所有生成結果,一股腦自動存回知識庫。
這樣做的風險是顯而易見的。一次未經確認的AI回答、一位員工的臨時判斷、一條只適用於特殊項目的處理經驗,都有可能被重新當成“企業知識”,繼續影響下一次回答。一旦錯誤進入正式知識體系,就可能在後續使用中被不斷放大。
所以,真正有價值的“知識回流”,更像一次受控的知識發布過程。
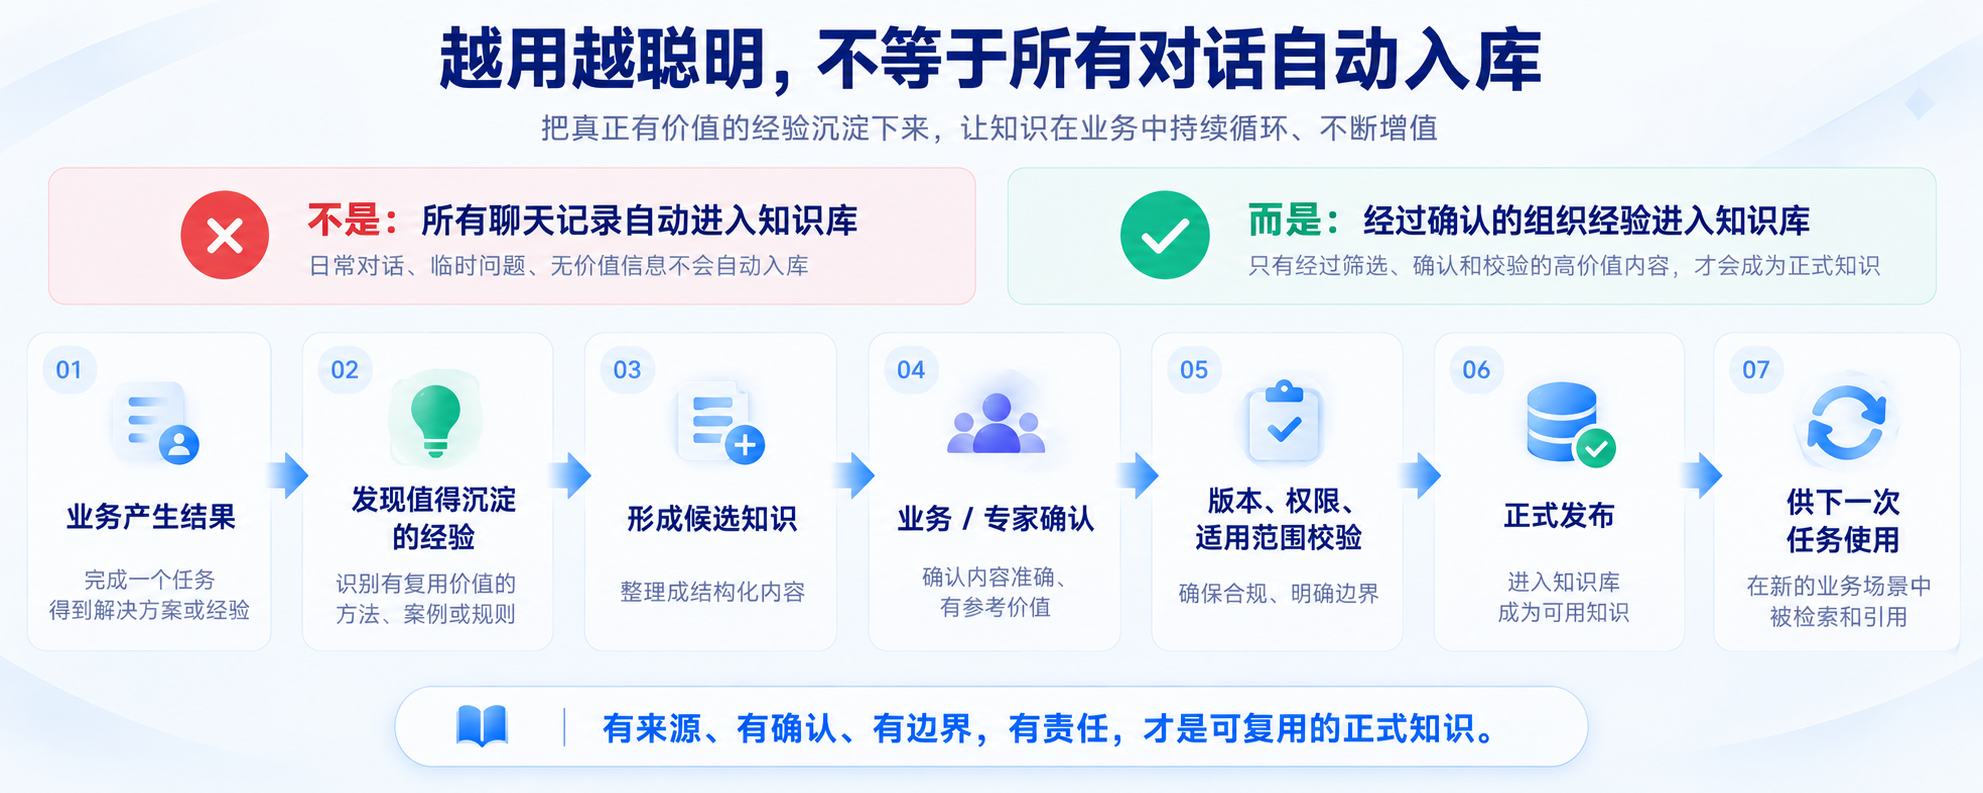
系統可以先從高頻問題、低滿意度回答、人工審核修改、工單處理結果和專家反馈中,發現值得沉澱的候選內容,再進一步判斷:哪些內容可以成為正式案例,哪些可以整理成模板,哪些應該補充到知識頁,哪些已經形成穩定方法,可以沉澱成新的Skill。最終,這些內容仍然需要經過必要的責任確認、版本管理和發布流程,才能進入正式可用的知識範圍。
例如在制造業現場,一次設備故障處理結束後,真正值得留下來的,不是員工與AI之間完整的聊天記錄,而是經過確認之後形成的一條故障案例:什麼情況下出現問題、涉及什麼設備、進行了哪些排查、最終原因是什麼、正確的處置步驟是什麼、有哪些風險,以及這套方法適用於哪些設備和條件。
在合規場景裡,值得沉澱的也不是一次問答本身,而可能是某一條審計意見最終如何修改、對應哪一版制度,以及以後遇到類似情況應該遵循什麼審核規則。
這些內容的共同特點是:
有來源、有確認、有邊界、有責任。
這才是企業真正能夠反複複用的組織經驗。
07 從“能回答”到“敢使用”,要守住四個關口
上一篇文章討論了Agent完成任務需要哪些企業上下文。到了這一篇,問題繼續往前走了一步。知識進入上下文以後,企業怎樣判斷它能不能用於當前任務,又能把任務推進到什麼程度。
落到360AI知識庫的產品設計,一條可信鏈路需要守住四個連續關口。每個關口都會影響任務能否繼續。
第一,來源可追溯。無論文件、表格、會議紀要還是結構化數據,進入系統之後,都需要保留明確的來源和證據位置。解析、分塊、摘要和標簽,不只是為了讓AI“搜得更準”,更重要的是保證最終形成的結論仍然可以回到原始依據。
第二,版本有狀態。企業知識不是靜態不變的。新的制度會替代舊制度,項目會進入新的階段,經驗也可能因為業務條件變化而失效。因此,每一個被Agent使用的知識,都應該保留版本、生效時間、適用範圍以及與曆史版本之間的關系。
第三,權限進鏈路。權限、密級、敏感內容檢測和召回過濾,共同決定哪些信息能夠進入這一次任務。AI不是“先把所有資料看完,再決定說什麼”,而應該從一開始就在企業允許的範圍內工作。
第四,過程可追蹤、結果可回流。一次任務中的檢索、引用、審批、Skill調用和結果保存,都應該形成可觀察的工作記錄。系統可以從高頻問題、低滿意度回答和人工修改中持續發現知識缺口,但只有經過確認的結果,才進入正式知識體系。
這樣一來,企業知識就不再是“一次導入、長期不動”的靜態文件庫,而是在真實業務中不斷經曆:
接入→ 理解 → 校驗 → 使用→ 反馈 → 修正 → 再使用。
知識在什麼狀態下可以使用,Agent能夠把任務推進到哪裡,出現問題以後由誰處理,都能在這套過程中找到明確答案。
寫在最後:可信,才是知識進入業務流程的通行證
當知識庫只用於搜索資料和回答問題時,企業主要關注檢索速度和答案準確率。知識庫進入制度審核、質量管理和風險研判以後,AI的回答會成為下一步業務動作的依據。版本用錯、權限越界或依據不足,都可能影響後續判斷。
企業可以先選一個邊界清楚的業務流程,把知識如何進入任務、結論怎樣得到確認、結果如何回到系統這件事跑通。
以制度審核為例,團隊先確定哪些資料屬於權威來源,梳理不同版本的狀態和生效時間,再明確審核人員與Agent各自擁有的權限。AI給出審核意見時,需要附上對應原文及適用範圍。資料存在沖突,或者當前依據無法支持結論,任務就進入人工確認。修訂結果經過審批後發布,舊版本同步更新狀態,整個處理過程留下記錄。
這一套流程穩定以後,企業再把同樣的方法擴展到其他場景。每增加一個業務場景,都要重新確認它認可哪些知識,由誰負責審核,Agent最多可以把任務推進到哪一步。
360AI知識庫希望幫助企業管好知識進入業務的全過程。員工可以核對每一項關鍵判斷,Agent也清楚自己的權限和任務邊界。到了這一步,企業才會把AI給出的結果用於下一項工作。
-
本文分類: 產品動態
-
浏覽次數: 77 次浏覽
-
發布日期: 2026-09-21 11:25:45
-
 華諾科技與360億方雲達成戰略合作,共推AI大模型產業化落地
-
 360億方雲AI增值服務上線,超大限時優惠等你來!
-
 央企控股上市公司引入360億方雲企業網盤,搭建智慧協同雲平臺
-
 中國水利水電第七工程局、北京石油化工學院等簽約360億方雲
您可能感興趣的文章
- 企業AI知識庫:一半是火焰,一半是廢品
- 8月&9月產品更新回顧|讓資料更好找,讓知識用起來
- 360 制造行業知識管理解決方案
- 新疆喀什地區某縣委機關與360億方智能成功簽約,共同推進政務辦公數字化升級!
- 放假前最後10分鐘,把散落的工作資料收進知識庫
- 360億方智能提供全程技術支持,助力泉州市數據應用職業技能競賽圓滿舉辦
- 企業關注的不再是“如何存儲文件”——IDC解讀中國智能企業內容與知識平臺市場
- 從“能回答”到“敢用於業務”:企業知識庫如何建立可信鏈路?
- IDC中國智能企業內容與知識平臺市場份額:360億方智能私有化市場第二,增速第一!
- 京新藥業攜手360億方智能,共建AI知識庫,讓醫藥知識常用常「新」
熱門推薦
最新推薦
- ISC.AI.2026· 數智化轉型資料合集
- 中國信通院·企業級智能體技術與應用研究報告(2026年)
- 走向Agent-Native!360AI知識庫打通業務底座,讓人與AI自然協同
- 告別重複勞動,億方雲如何讓多家律所跑出「AI加速度」?
- OpenClaw x 億方雲Skill:用OpenClaw調教出的“AI團隊”,比我本人還卷
- OpenClaw × 億方雲|能幹活、有記憶、懂業務,這才是企業想要的“數字員工”
- 航空AI白皮書發布,重塑航空未來,讓知識成為生產力
- 360億方智能 ·航空AI白皮書
- 智慧升級,教育革新:200+高校選擇360億方雲,共繪智慧校園藍圖
- 亮相2024 AI+研發數字(AiDD)峰會,360智能文檔雲引領行業AI生態建設

 企業雲盤
 AI 知識庫
 浙公網安備 33011002015048號
 在線客服
 電話諮詢